2026年9月15日、“Jev(ジェヴ)”というAIが公開され、AI界隈が一気にざわつきました。作ったのは、元OpenAIの研究者が立ち上げたTypeSafe AIです。
TypeSafe AI公式サイト
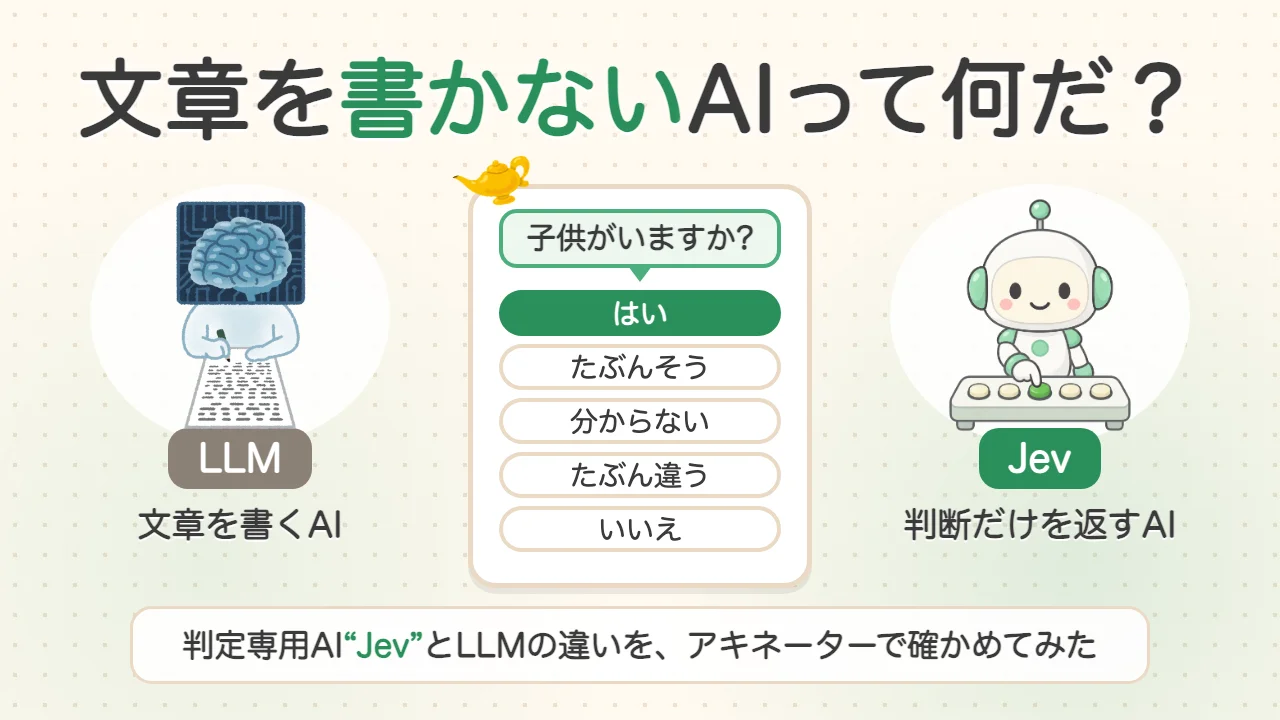
ざわついた理由は、このAIが文章を書かないから。チャットの相手もコードも書いてくれません。やることは“判断”だけです。
文章を書かないAIって、一体何に使うの?ChatGPTやClaudeと何が違うの?・・・また難しそうなのが出てきた・・・
大丈夫です。本記事では、LLMと比べながらJevの正体を噛み砕いて解説します。最後に、私がJevに“アキネーター”を遊ばせた実験も紹介します。理屈では見えない違いを、わかりやすく実測値にしてみましたー。
では、さっそくいきましょう!!
Jevって何だ? LLMとの違い
文章ではなく「型つきの判断」を返す
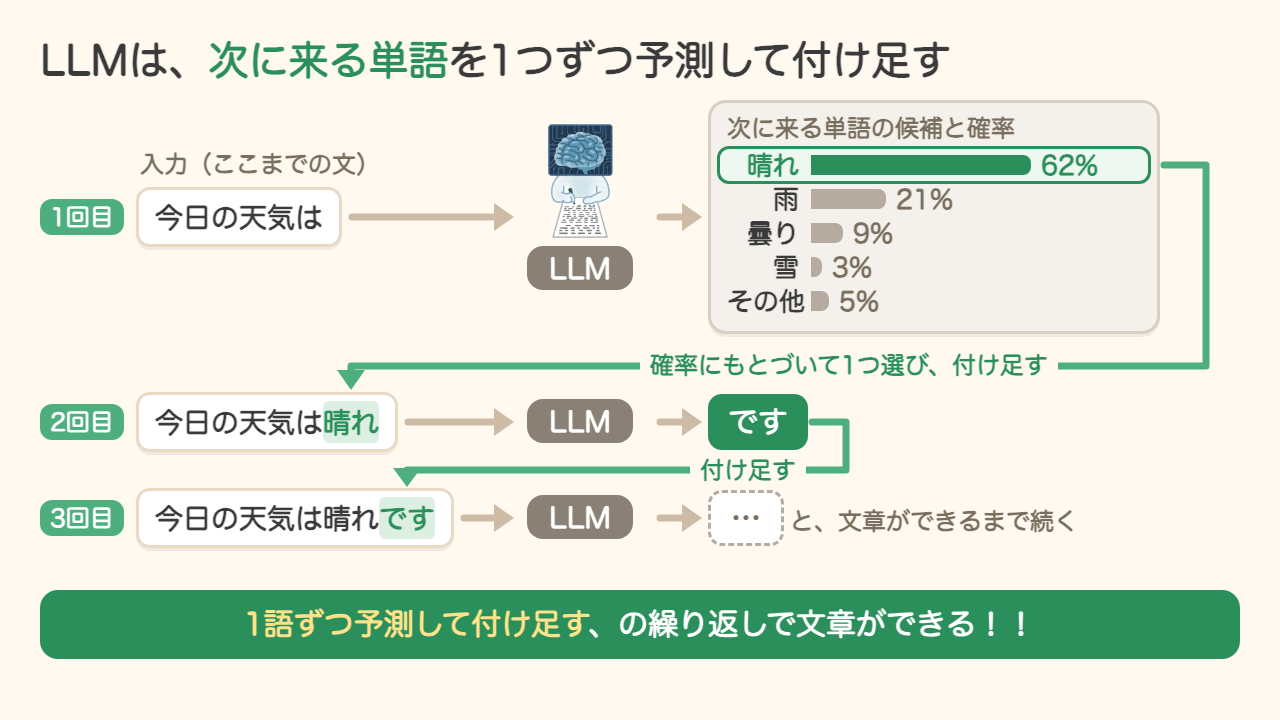
ChatGPTやClaudeのようなLLMは、次に来る単語(トークン)を1つずつ予測して文章を作るAIです。「今日の天気は」の次に来そうな単語を確率で並べ、確率にもとづいて1つ選んで付け足す。付け足した文からまた次の単語を予測する・・・この繰り返しで文章ができあがります。何でも書ける代わりに、何が返ってくるかは分かりません。
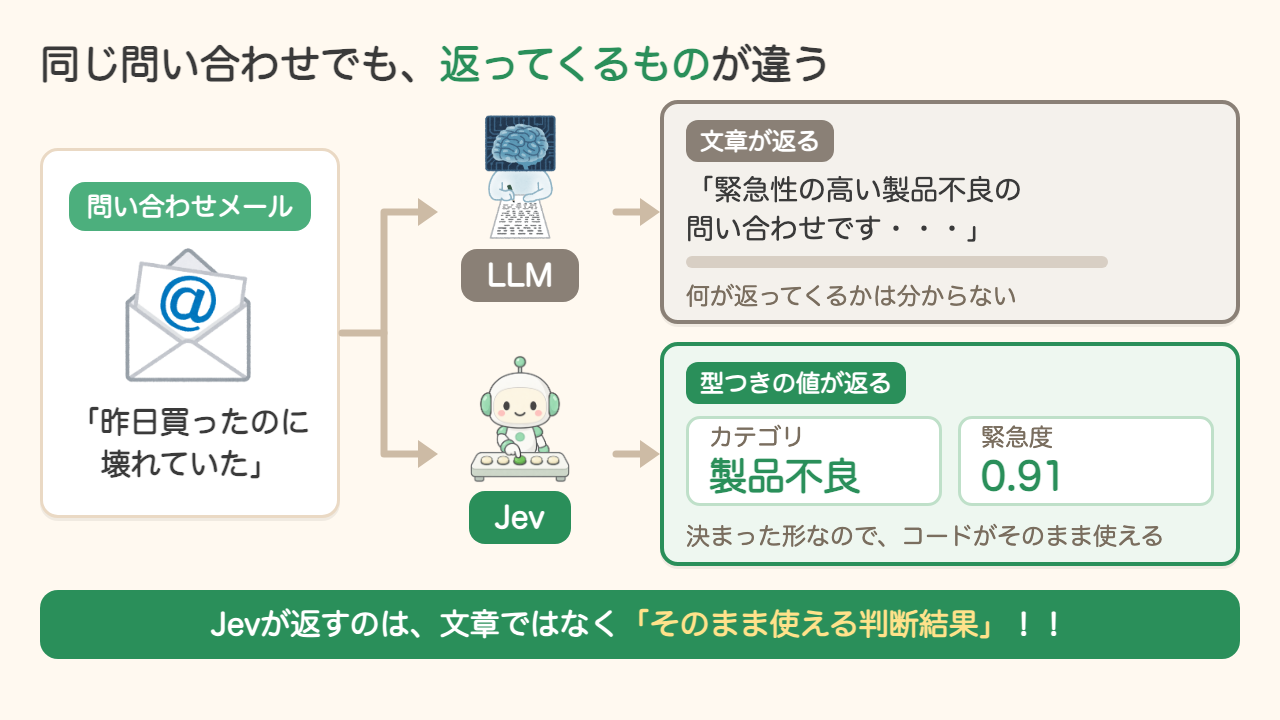
Jevは根本から違います。State(状況)と型つきの質問を受け取り、決まった形の答えと確率を返す。公式も「コードがそのまま使える構造化された答えが返る」と説明します。
TypeSafeは、こうしたAIを“System One Model”と呼んでいます(同社が提唱している呼び名です)。名前の由来は、心理学者のダニエル・カーネマンが著書『ファスト&スロー』で広めた、直感的で速い思考“システム1”です。


たとえば「昨日買ったのに壊れていた」という問い合わせ。LLMは文章で「緊急性の高い製品不良の問い合わせです・・・」と返しますが、Jevが返すのは、製品不良というカテゴリと緊急度0.91だけ。そのまま使える判断結果なのです。
答え方は3種類 — Choice・Score・Noul
判断の型は現在3つ。選択肢から1つ選ぶ“Choice”、決めた尺度で点をつける“Score”、命題が真である確率を0〜1で返す“Noul”です。ChoiceとScoreはconfidence(確信度)も返します。
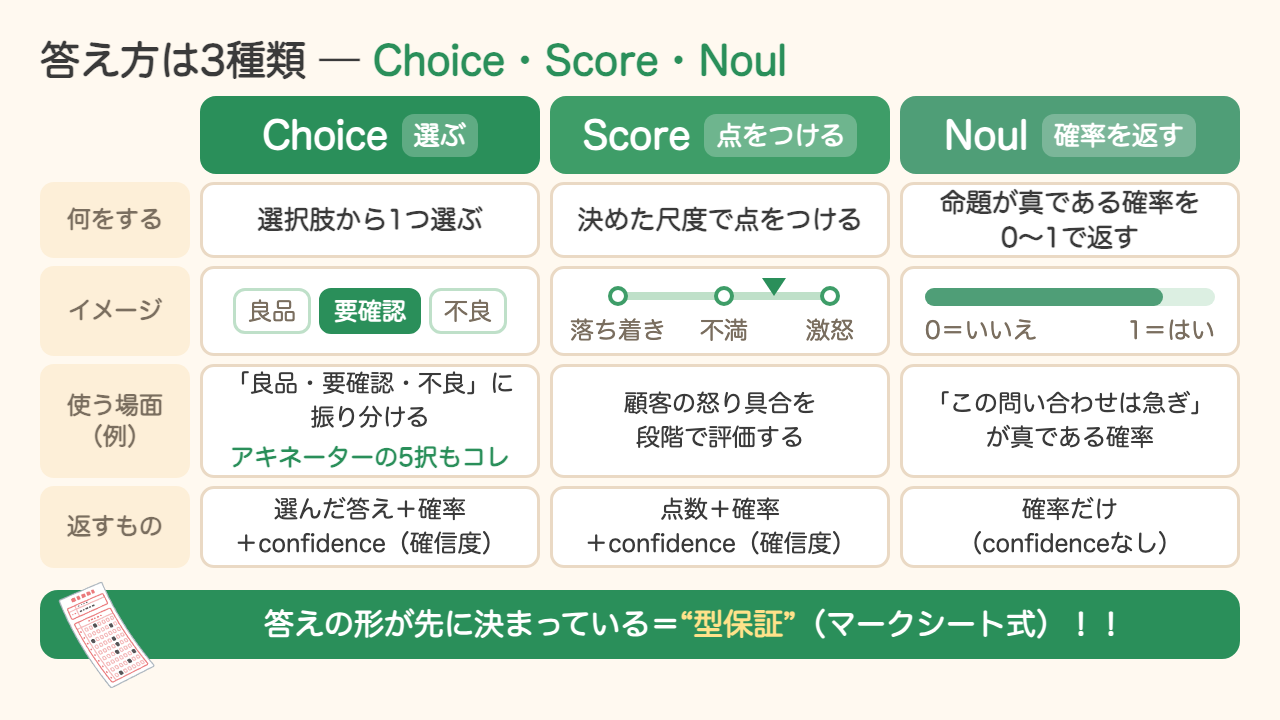
大事なのは、答えの形が先に固定されている点。これを“型保証”と呼びます。記述式のテストではなく、マークシート式だと思ってください。
TypeSafeはこれを「Jev can't hallucinate」「Zero Hallucinations」と強く表現します。ハルシネーションとは、AIがもっともらしい嘘を作ってしまうこと。ただし根拠は、定義していない型の答えを生成しない一点だけで、「0%」も実測値ではないそうです。
マークシートでも、マークする場所を間違えることはありますよね。型保証は「間違えない仕組み」ではなく「変な答え方をしない仕組み」なんです。
「賢いif文」という立ち位置
「温度が80度を超えたら停止」はコードで書けますが、「この問い合わせは怒っている顧客っぽいか」はif文(条件分岐)では書けません。この隙間を埋めるのがJev。ルールで書ける判断はコードに任せ、意味が分からないと無理な判断だけを渡すわけです。だからJevは、自分で次の手を考えて動き回るAIエージェントではなく、組み込んで使う“判断用の部品”なんですね。
なぜ速くて安いのか
1トークンずつ文章を生成しないから、というのが理由の1つ。もう1つは、複数の質問を並列に、独立して評価する設計だから。公式にも「質問を増やしても応答時間はほとんど変わらない」とあります。
料金は入力100万トークンあたり0.042ドルで、出力は無料。どれくらい効いてくるのかは、後半の実測で見ていきましょう。
ここまではJevの“外側”の話。本当の面白さは、返ってくる確率の中身です。なぜ信用してよいのか・・・根拠を見ていきましょう。
Jevの核心は「信用できる確率」— RLCD
その80%を信用してよいのか ―“校正”という考え方
そもそも、確率を返すAI自体は珍しくありません。「クレームである確率80%」くらいならLLMでも言えます。問題は、その80%を信用してよいのかなのです。
LLMはRLHF(人間のフィードバックによる強化学習)で磨かれています。ただし公式のAI入門ページは副作用も正直です。「人が好むこと」を言うよう教えるので、迎合や自信ありげなハルシネーションにも報酬を与える、と。
そこでJevが採ったのがRLCD(Reinforcement Learning for Calibrated Decisions)、「校正された判断のための強化学習」です。
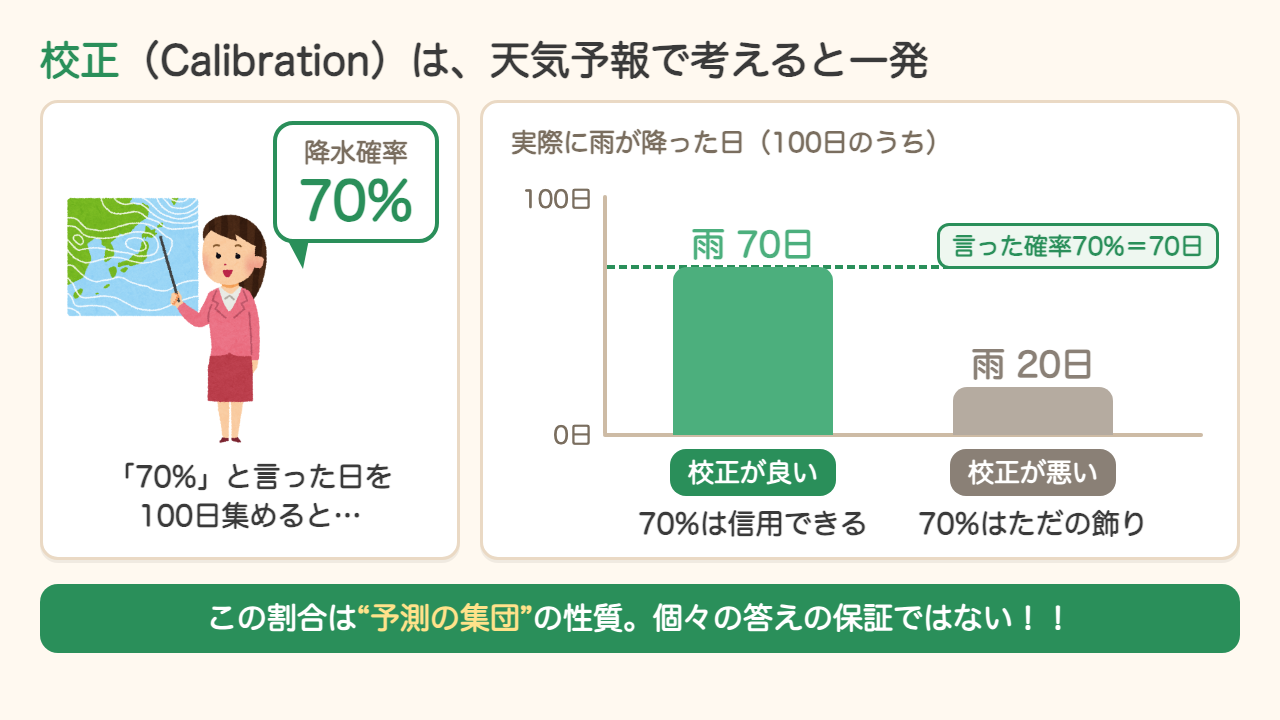
校正(Calibration)は天気予報で考えると一発ですね。「降水確率70%」と言った日を100日集めて、70日くらい雨なら、その70%は信用できる。20日だけなら、ただの飾りですよね。
ただし、必ず添えられている但し書きも重要です。この割合は予測の集団についての性質であって、個々の答えの保証ではないのです。
ここで鋭い人はこう思うはずです。「選択肢から1つ選んで確率を出すだけなら、昔からある機械学習の“分類”と同じでは?」と。
たしかに、見た目はそっくりです。少し寄り道して、機械学習の“分類”がどう動くのかをサラッと見ておきましょう。
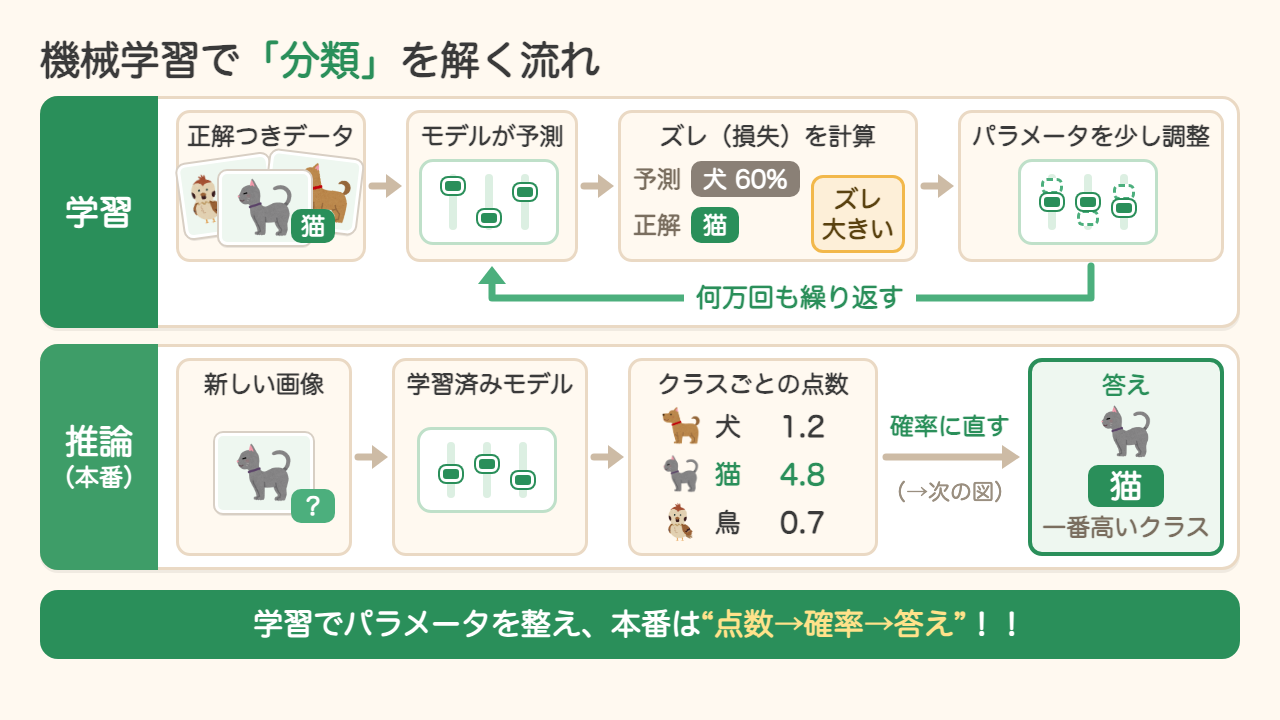
機械学習で「分類」を解く流れ
“分類”とは、入力されたデータを、あらかじめ決めたグループ(クラス)のどれかに振り分ける問題のことです。画像を「犬・猫・鳥」に分ける、メールを「迷惑メールか、そうでないか」に分ける、といった具合ですね。この振り分けをするモデルを“分類器”と呼びます。
分類器づくりは、大きく2つのステップに分かれます。
1つ目は学習。「この画像は猫」のように正解(ラベル)をつけたデータを大量に用意して、モデルに予測させます。予測と正解のズレ(損失)を計算し、ズレが小さくなるように、モデルの中のパラメータ(予測を決めている大量の数値)を少しずつ調整する。これを何万回と繰り返すと、だんだん当たるようになっていくわけです。
2つ目は推論、つまり本番です。学習済みのモデルに新しい画像を入れると、クラスごとの“点数”が出てきます(Jevの“Score”とは別物です)。この点数を確率に直して、一番高いクラスを答えにします。
点数を確率に直す「シグモイド」と「ソフトマックス」
では、点数はどうやって確率に直すのか。ここで登場するのが“シグモイド関数”と“ソフトマックス関数”です。
答えが2つしかない2クラス分類なら、シグモイド関数を使うのが定番です。シグモイドは、その名の通り“S字(シグマの形)”のカーブを描く関数。「迷惑メールか、そうでないか」のような問題では、点数は1つで足ります。シグモイドはその点数を0〜1の範囲に押し込んで、「迷惑メールである確率」に変えます。点数が2.0なら約88%、0なら50%、マイナス2.0なら約12%です。
候補が3つ以上の多クラス分類なら、ソフトマックス関数。犬・猫・鳥のように、候補ごとに点数が出ます。ソフトマックスは“やわらかいマックス”という意味で、一番大きい候補だけを選ぶ(マックス)のではなく、点数が大きい候補ほど大きな確率を“やわらかく”割り振ります。全部の点数を、合計がちょうど100%になる確率に変換するわけです。犬1.2、猫4.8、鳥0.7という点数なら、猫が95.8%、犬が2.6%、鳥が1.6%(足すとちょうど100%)です。
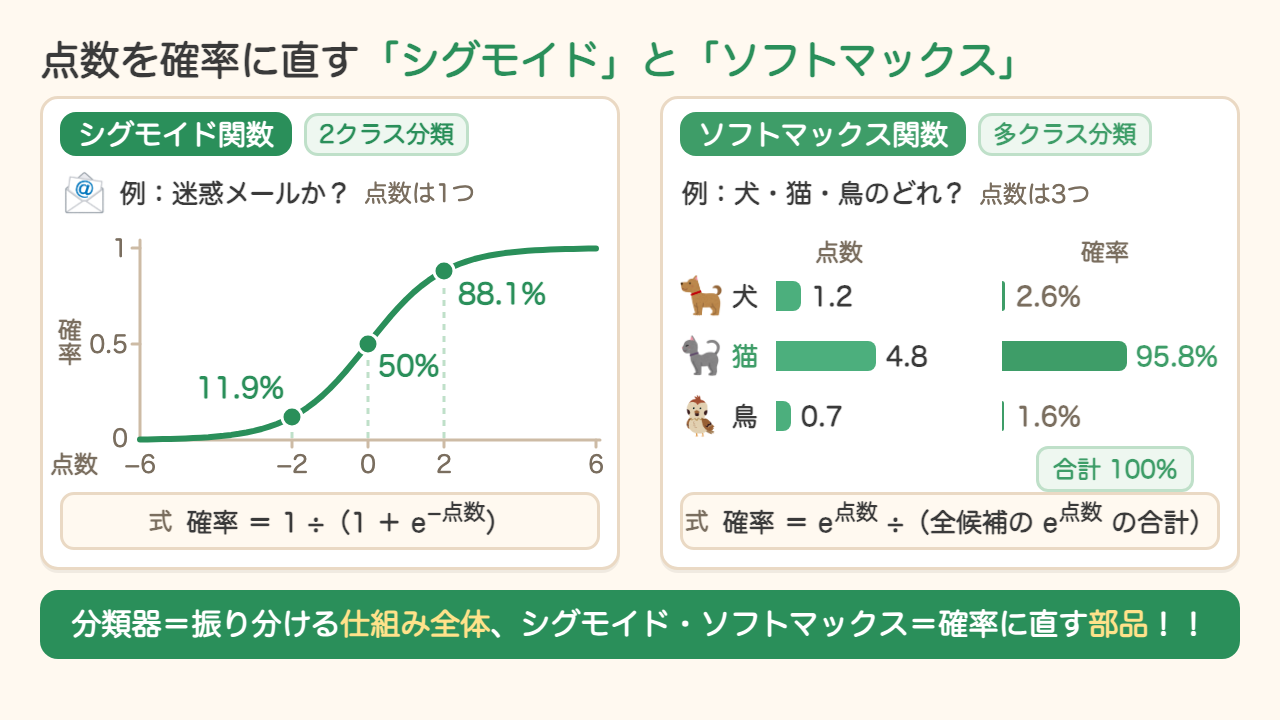
つまり、分類器は“振り分ける仕組み全体”のこと。シグモイドやソフトマックスは、その最後で点数を確率に直す“部品”なんです。ここはごちゃ混ぜになりやすいポイントですね。
ちなみに、冒頭で紹介したLLMが次の単語を選ぶときの確率も、実はこのソフトマックスで作られています。LLMの“次の単語当て”も、見方を変えれば、膨大な数の単語から1つを選ぶ多クラス分類なんですね。
Jevの「選ぶ」と何が違うのか
Jevの答え方も、出力の形だけを見れば、これとそっくりです。Noul(「はい」である確率を0〜1で返す)はシグモイドの出力に、Choice(選択肢ごとの確率を返す)はソフトマックスの出力に、それぞれよく似ています。ただし、Jevの中身が本当にこの仕組みなのかは公開されていません。
違いは2つあります。1つは、分類の内容を自然言語でその場で定義できること。昔ながらの専用の分類器は、犬・猫・鳥を見分けたければ犬・猫・鳥の正解データを集めて学習させる必要があり、「良品・要確認・不良」に変えたければ、またデータを集めて学習し直しです。Jevは選択肢を文章で書くだけ。ただし、Jevが今読めるのは文章だけで、画像はまだ扱えません。
もう1つは、確率の校正を訓練の中心に置いていること。ソフトマックスの95.8%は、あくまで候補どうしの点数を比べて割り振った数字。本当に95.8%の確率で当たるとは限りません。自信満々に外すこともあります。
さきほどの天気予報の話を思い出してください。Jevが目指しているのは、この%そのものを信用できる数字にすることなのです。
Jevは、この選択肢ごとの確率がどれだけ1つに集中しているかから、confidence(確信度)も計算して返します。1つに集中していれば高く、散らばれば低い。高ければ自動で実行、中くらいなら確認、低ければ人間に回す、と切り替えられます。ただし、校正の性能はTypeSafe自身の評価が中心です。
分類や確率の出力そのものは、昔からある技術です。Jevの新しさは、それを“文章で定義できる汎用の判断部品”として、確率の校正までセットでまとめたところにある、と言えるのではないでしょうか。
理屈はこれくらい。ここからは実際に動かしてみた話です。
素朴な実験で確かめる
Jevの応用例として目を引くのは、ロボット操作やゲームプレイのような派手なものです。ですが、Jevの仕事は「状況を見て、選択肢から1つ選ぶ」という驚くほど地味なものです。この地味さを素朴に見せる題材が、“アキネーター”でした。
あなたも一度は遊んだことがありませんか。質問に「はい/たぶんそう/分からない/たぶん違う/いいえ」の5択で答えると、思い浮かべた人物を当ててくるゲームです。
アキネーター(日本語版)
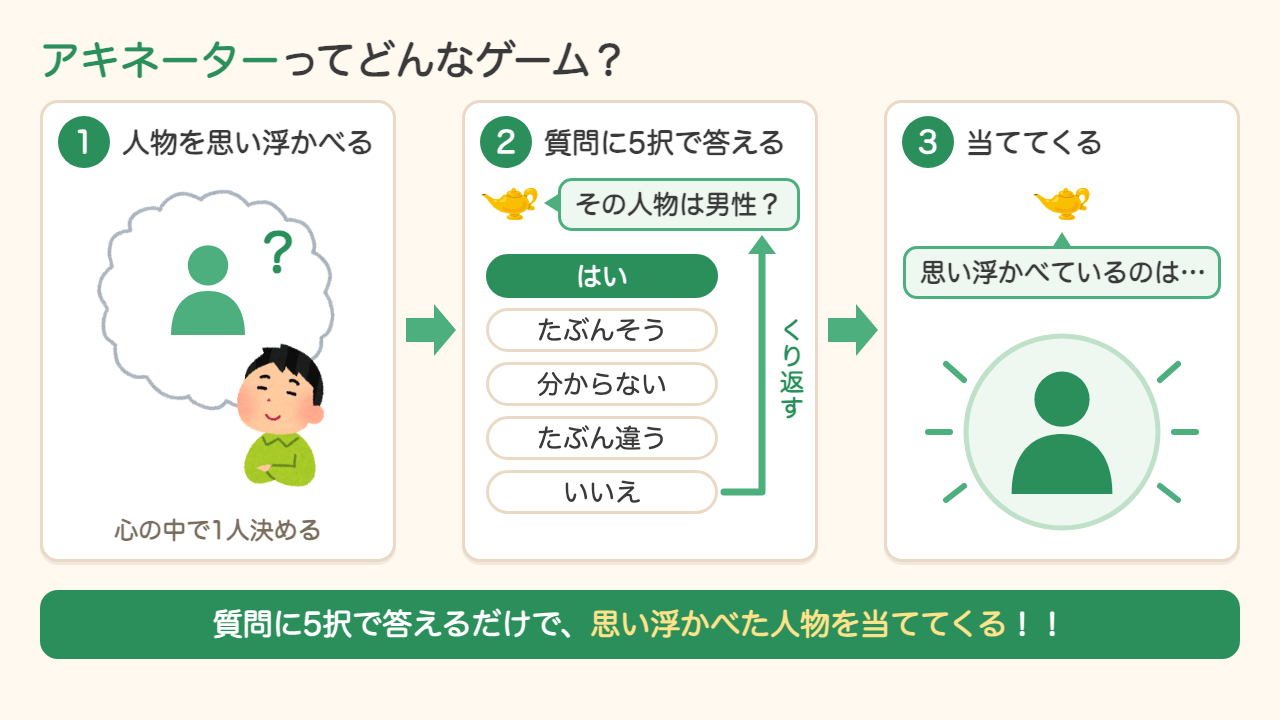
選んだ理由は、5択がそのままJevのChoiceに対応するから。お題は、“日本一のYouTuber”とも呼ばれるHIKAKINさん。これだけ有名なら、アキネーターも辿り着きやすいはずです。
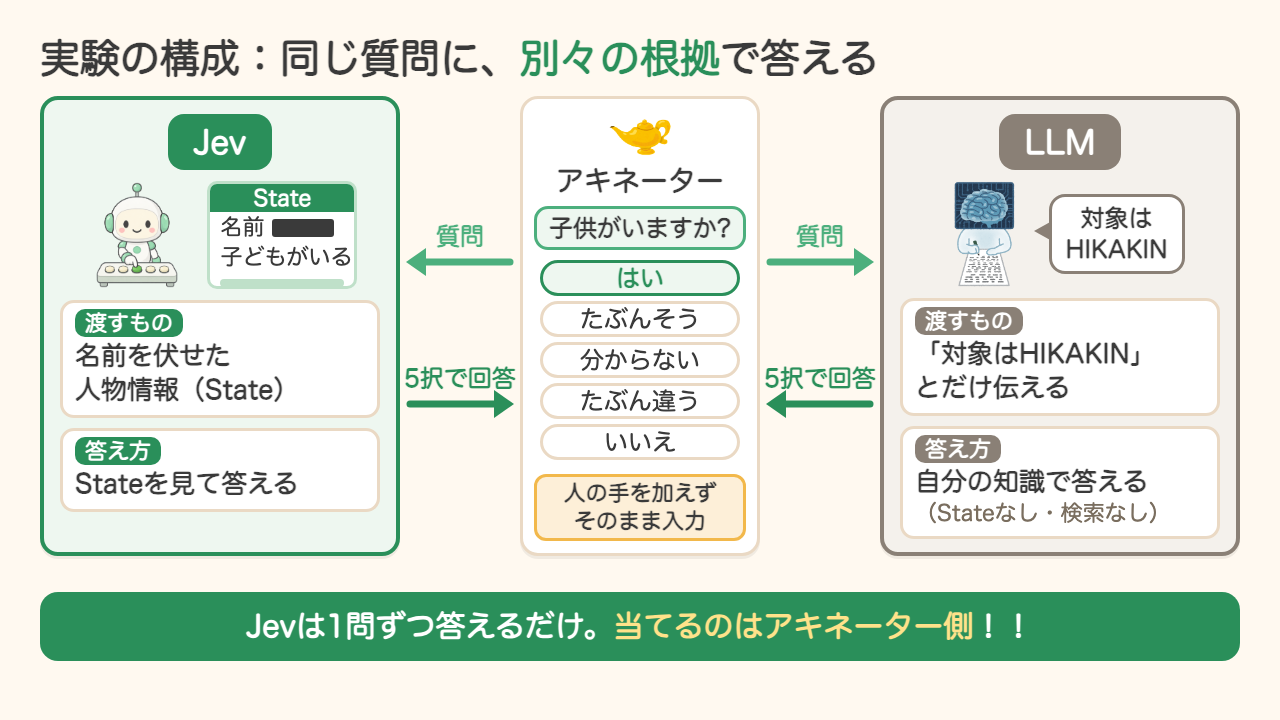
実験の形はこうです。
- Jev側: 名前を伏せ、名前を含まない人物情報(State)だけを渡して5択から選ばせる
- LLM側: 「対象はHIKAKIN」とだけ伝え、モデル自身の知識で答えさせる(Stateなし・検索なし)
- どちらの答えも人の手を加えず、そのまま本物のアキネーターに入力する
Jevは「この人は誰か」を当てるのではなく、「このStateなら、この質問にどう答えるのが妥当か」という小さな判断を繰り返すだけ。当てるのはアキネーター側です。なお自動操作は、ロボットでない確認だけ自分で通し、1ゲームずつ目の前で動かしました。
JevとLLMを比べてわかったこと
まずは結果から。実ゲームと、同じ127問を投げ直した再生テストの数字です。
| 項目 | Jev(Stateを見て答える) | LLM(自分の知識で答える) |
|---|---|---|
| 実ゲームの結果 | 正解 | Sonnet 5: 不正解 |
| 質問数 | 48問 | 74問 |
| 回答時間の合計 | 15秒 | 108秒 |
| 費用 | $0.007 | $0.083 |
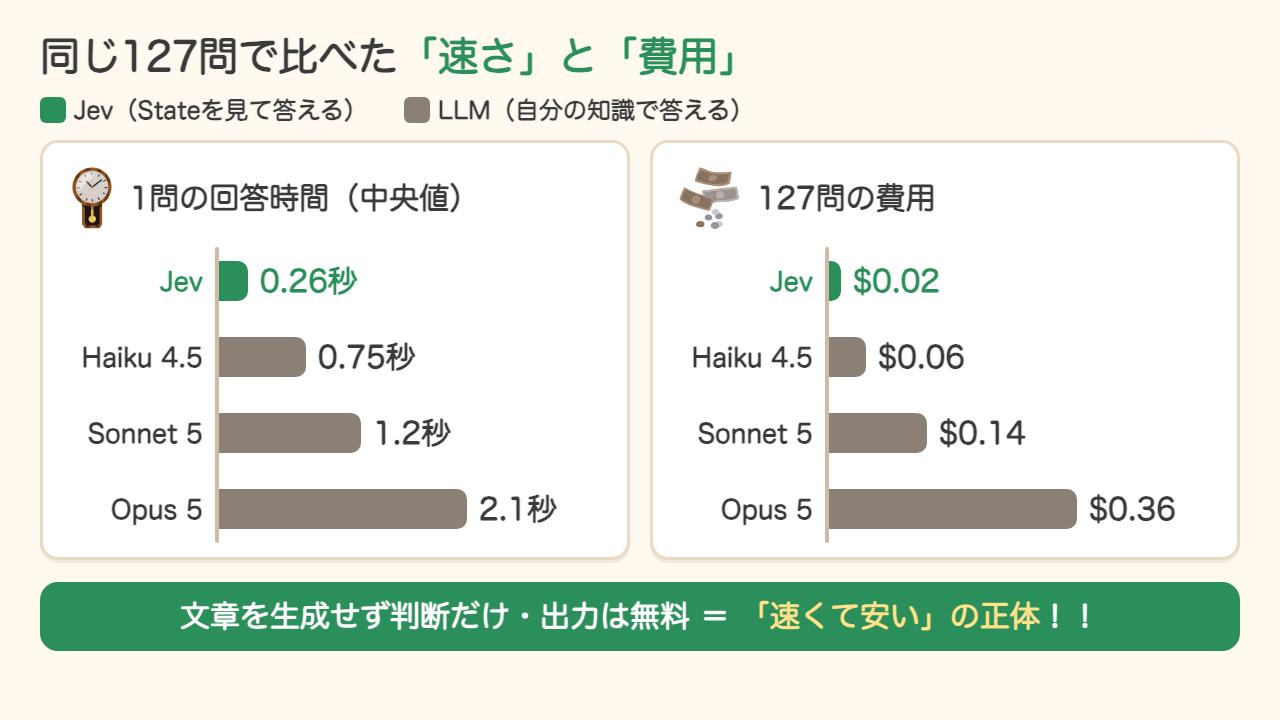
| 同じ127問の回答時間(1問) | 0.26秒 | 0.75〜2.1秒 |
| 同じ127問の費用 | $0.02 | $0.06〜0.36 |
利点① とにかく速くて安い
表のとおり、前半で説明した仕組みが、そのまま数字に出ていますね。文章を生成せず判断だけを返す、出力は無料・・・これが「速くて安い」の正体です。
利点② 答えがぶれない
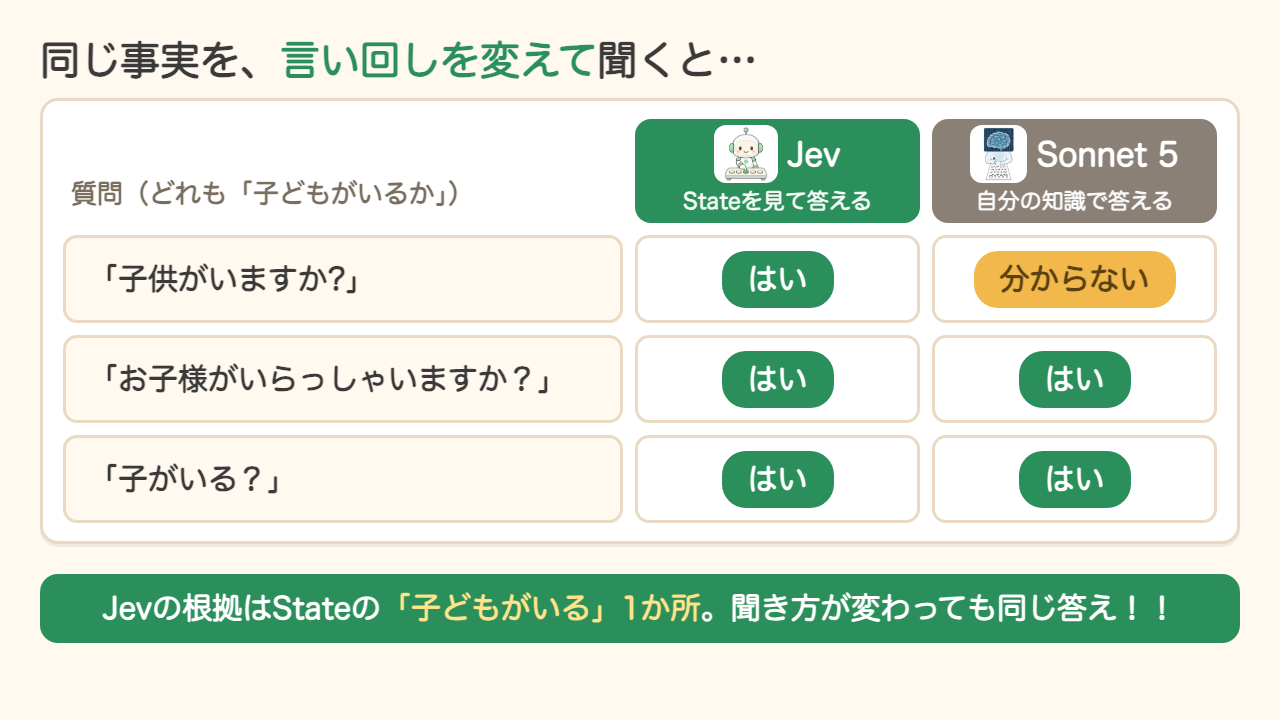
Jevの根拠はStateの1か所だけ。そこに「子どもがいる」と書いてあるので、「子供がいますか?」「お子様がいらっしゃいますか?」「子がいる?」のどれにも「はい」と答えました。
一方、記憶で答えるLLMは見事に揺れます。Sonnet 5は同じ3問に「分からない」「はい」「はい」とバラバラ。「弟がいる?」に「はい」と答えた2問あとの「弟がいる?」では「分からない」に戻りました。
厄介なのは、モデルごとに“知っていること”が違う点です。「セイキンと兄弟ですか?」にOpus 5とSonnet 5は「はい」、Haiku 4.5だけが「いいえ」。セイキンさんが兄というのは広く知られた話ですから、これはHaikuの記憶違いでしょう。
つまり、LLMの記憶に頼ると「何を知っていて何を知らないか」をこちらで決められない。State方式なら、根拠を自分で決められます。
利点③ 確率が“曖昧さ”を教えてくれる
面白かったのが「Youtube関係者?」です。答えは「はい」でしたが、確率は「はい」0.57、「いいえ」0.2前後と割れ、confidenceも0.5前後どまり。Stateを減らすと「いいえ」に転びました。
「YouTuberか」とも「YouTube社の人か」とも読める曖昧さが、数字に出た形ですね。LLMも中では確率を計算していますが、普段の使い方では選んだ答えしか返ってこないので、この迷いは見えません。confidenceの低い質問だけ人間に回せる。これこそ確率を返すAIの価値ではないでしょうか。
当然、欠点もある
とはいえ、弱点もはっきり出ました。
まず、Stateに書いていないことには答えられません。「セイキンと兄弟ですか?」のような固有名の質問に、Jevは「分からない」を返し続けます。おかげで最初の提示は兄のセイキンさん。19問後にHIKAKINさんへ辿り着きました。
Stateを10分の1まで削ると、127問中91問が「分からない」に。実ゲームでは、アキネーターに「捉えどころのないプレイヤー(いつも『わからない』と答える賢い人)」と言い当てられました。見抜かれてる・・・。
ただし、これは長所の裏返しです。情報を削られても、Jevは推測で埋めません。元のStateと正反対の答えは0問。知らないことは「分からない」と言う。判定用のAIとしては、むしろ信頼できる性質だと思いませんか。
公式は弱点も公開しています。Jevは質問を文字どおりに読むので、“意図した質問”ではなく“書いた質問”に答えます。数を数えるのも、日付を順序として比べるのも苦手。だから同社も「計算と日付比較はコードでやれ」「複雑な判断は分解しろ」と書いています。
なお、RLCDの核心である確率の校正そのものは検証できていません。Stateを書いて事実確認をするのは人間ですし、Jevは文章も書けない。ここは正直に。
結局、Jevはどう使うものか
ここまでのまとめをすると、Jevは「型の決まった判断」を「信用できる確率つき」で速く安く返すAI。LLMの置き換えではなく、組み込む判断用の部品というわけです。
- 文章を作る、要約する、コードを書く → LLM
- 意味を理解しないとできない判断 → Jev
- 数値やルールで書ける判断 → 普通のコード
ものづくりの現場なら、使いどころはすぐ浮かびます。検査記録や作業者のコメントを読んで「良品・要確認・不良」に振り分ける。不具合報告を担当部署に回す。人がやると気が重い判断ほど、部品に切り出せるはずです。
私は機械設計の文脈で何かうまく使えないか考え中・・・なんでもLLMに丸投げせず、判断をどう組み込むのかを考えていく視点。今後のAI活用において、重要になってきそうな予感がしますね!!
まとめ
本記事の内容を復習しましょう。
- Jevは文章を生成せず、型の決まった判断と確率を返すAIで、LLMとは訓練の目標が違う
- 型保証は「間違えない仕組み」ではなく「変な答え方をしない仕組み」で、選び間違いはある
- RLCDは確率そのものを信用できるようにする訓練で、天気予報の降水確率と同じ考え方
- 分類や確率の出力は昔からある技術。Jevの新しさは、文章で選択肢を決められる判断部品に、確率の校正までセットにしたこと
- 実験ではJevが48問・15秒・$0.007で正解、知識で答えたLLMは74問・108秒・$0.083で不正解
- Jevは根拠がStateの1か所なのでぶれず、LLMは聞き方やモデルで答えが揺れた
- Stateに無いことは答えられず、計算や日付比較も苦手なので、コードとの分業が前提になる
LLMが出てきたとき、私たちは「AIに何でも聞けるようになった」と喜びました。Jevが示すのは逆方向・・・担当範囲を狭くして信頼性を上げる道です。あなたの仕事にも、正確に判断してほしいだけの場面がありませんか。是非とも、そういう場所を探してみてください。