※本記事はBright Data社の依頼を受けて執筆したPR記事です。セミナー内容の解釈と感想は筆者自身のものです。
この記事は、Bright Data×APTOのセミナーのアーカイブ動画を見て、私が考えたことを語る視聴レポートです。セミナーの要点を紹介しながら、調べて分かったことも交えて考察していきます。
【アーカイブ動画】セミナーをYouTubeで見る(約75分)
職人の世界には「技は見て盗め」という言葉がありますよね。情報社会の現代では、ひとたびWebを開けばあらゆるハウツー動画が山ほどあり、ある意味で技を盗み放題な時代です。やり方がわからないことがあったら「とりあえずYouTubeを調べてみよー」、なんて思ったことは、一度や二度ではないはずです。
昨今は、AIが人間のタスクをどんどんと代替しています。動画から学びを得て動きを覚える・・・この人間的な営みすらAIができたらどうでしょうか。
実はそんな話が、Bright Data主催・APTO共催のセミナーで取り上げられました。2026年8月28日に東京・神田で開かれた「センサーからWebへ — Physical AIを支える統合データパイプラインの構築」というセミナーです。アーカイブ動画(約75分)で視聴した中でも、特に印象に残ったやり取りです。
動画を見せるだけで学習できるの?
そもそもロボットってどうやって学習してるの?
本記事では、まずフィジカルAIの基本と、ロボットの"教材"づくりに動く日本の今を押さえ、そのうえでセミナーで語られた内容を"答えのピース"として並べていきます。では、さっそくいきましょう!!
そもそも"フィジカルAI"とは? — 日本が国を挙げて期待する理由
まずは、公開資料からセミナーの前提を押さえておきます。
フィジカルAIって何だ?
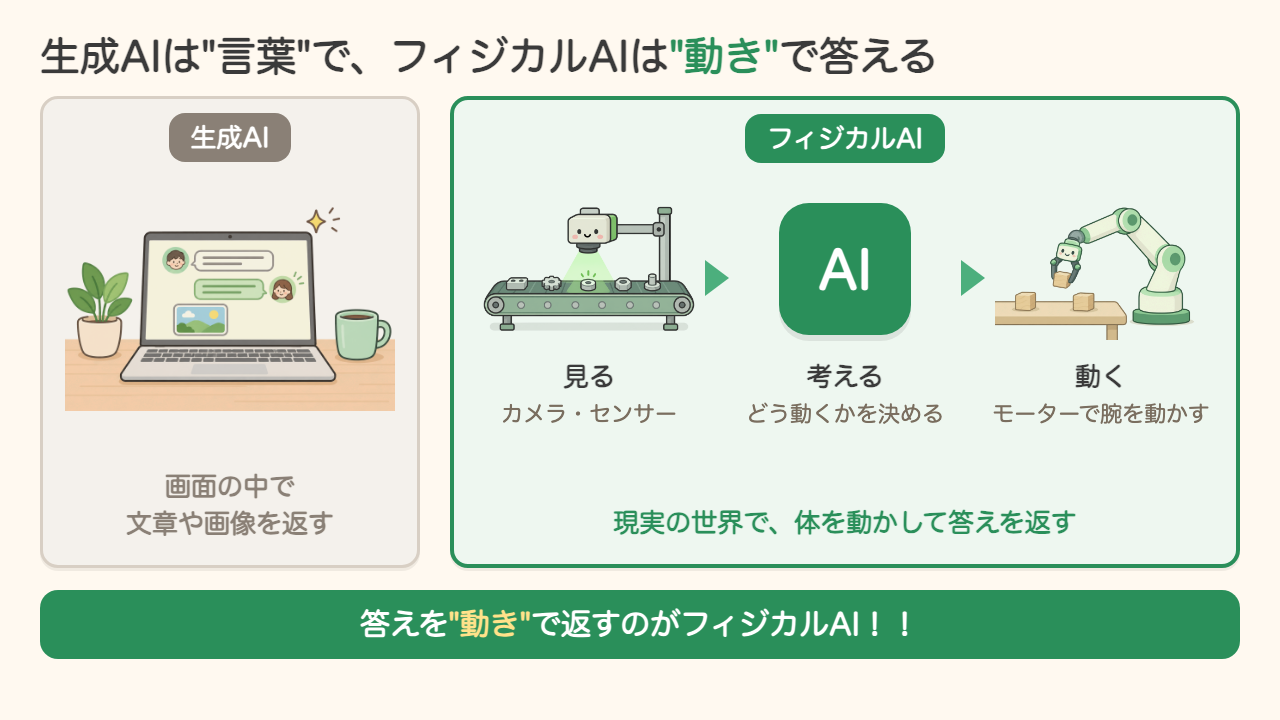
ChatGPTのような生成AIは、画面の中で文章や画像を返してくれますよね。フィジカルAIは、その答えを"動き"で返すAIです。カメラやセンサーで周りを見て、どう動くかを考え、モーターで腕や車輪を動かします。周りを認識して動きを判断するロボットアームや自動運転車が、その代表例です。
NVIDIAは、ロボットや自動運転車などが物理世界で認識・理解・推論し、行動まで実行できるようにするAI、と定義しています。日本政府も2026年7月の資料で、現実世界を理解して行動を生み出すAIと説明しています。
この分野にとりわけ強気なのが、NVIDIAのジェンスン・フアンCEOです。2025年1月には「汎用ロボティクスにとってのChatGPTモーメントは、すぐそこまで来ている」と語り、2026年1月には「ロボティクスのChatGPTモーメントが来た」と言い切りました。ChatGPTが一気に広まったような転機が、ロボットにも訪れたということです。
人手不足の日本で、期待が大きい理由
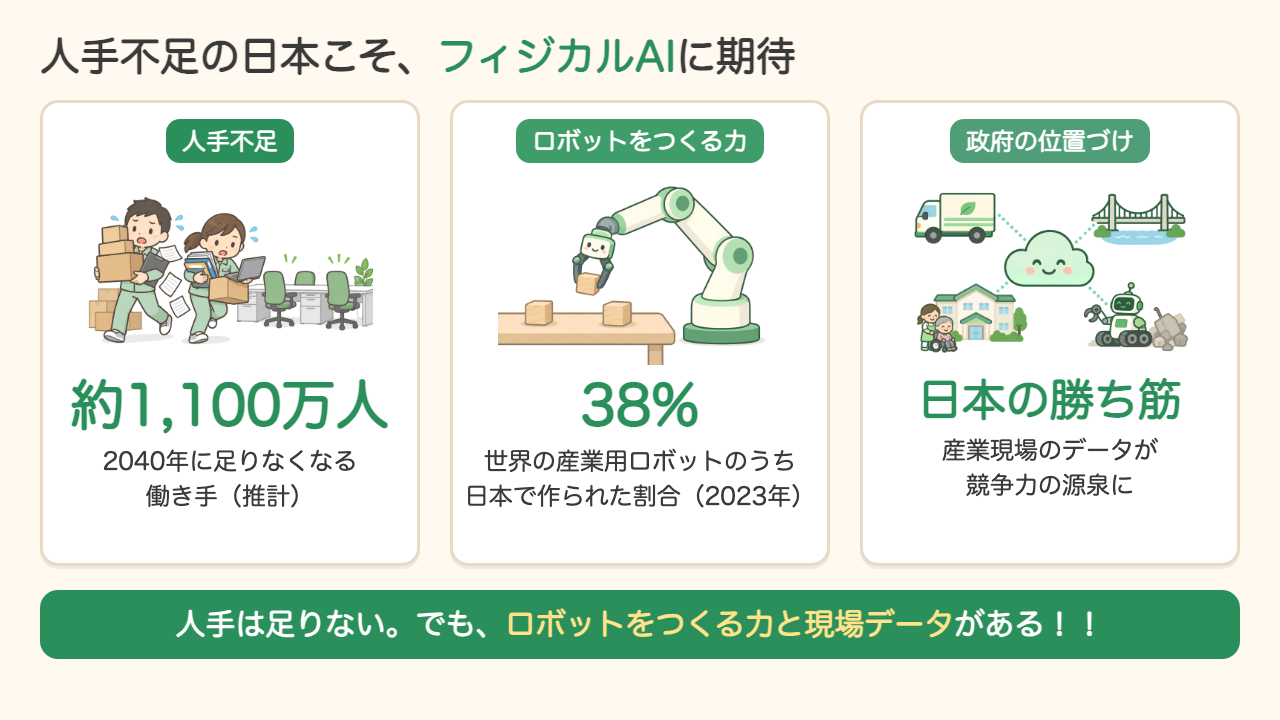
こうしたAIが現場の仕事を担えるなら、人手不足の日本にとっては喉から手が出るほど欲しい存在です。実際、リクルートワークス研究所の2023年の推計では、2040年に全産業で約1,100万人分の働き手が足りなくなる見込みで、人手不足はもはやネガティブな意味で「約束された未来」といって過言ではありません。
一方で、日本にはロボットの"体"を作る力があります。国際ロボット連盟(IFR)によると、2023年に世界で生産された産業用ロボットの38%は日本で作られました。ロボットの体づくりは、日本の得意分野なんですね。
政府もフィジカルAIを"日本の勝ち筋"と位置づけています。2026年7月16日の政府の政策イベントで、高市総理は製造や物流、インフラなど日本が強い「産業現場」のデータが競争力の源泉になる、とメッセージを寄せました。同じ場で赤澤経産相も、超高齢社会で災害大国だからこそデータがある、「ピンチのように見えてそこが勝ち筋」と語っています。
国も動き出した — Noetra(ノエトラ)とAIRoA
フィジカルAIの導入には、ロボットを動かすAIと学習データが欠かせません。国は2026年3月に「AIロボティクス戦略」を決め、2040年までに1,000万台規模のAIロボットを国内に導入する目標を掲げました。
AIの土台づくりで代表的なのが、2026年7月に事業を始めた民間企業Noetra(ノエトラ)ですね。文章や画像、音声などをまとめて扱える国産の基盤モデルを日本の大企業オールスターで担って開発していこうという取り組みです。ソニーグループ、ソフトバンク、NEC、Hondaを中心に44社が出資し(2026年7月の発表時点)、ファナックや安川電機、川崎重工業も名を連ねていて、非常に心強い顔ぶれです。国の事業にも採択されていて、事業全体の2026年度予算は3,873億円です。
データの面で動いているのが、ロボットのデータづくりを進める団体、AIロボット協会(AIRoA)です。国のデータ基盤づくり(4年間で205億円)を担っていて、別の国の支援事業の成果として、2026年7月には約5,000時間分のロボットの動作データと、そのデータで学ばせたモデルを一般公開しました。
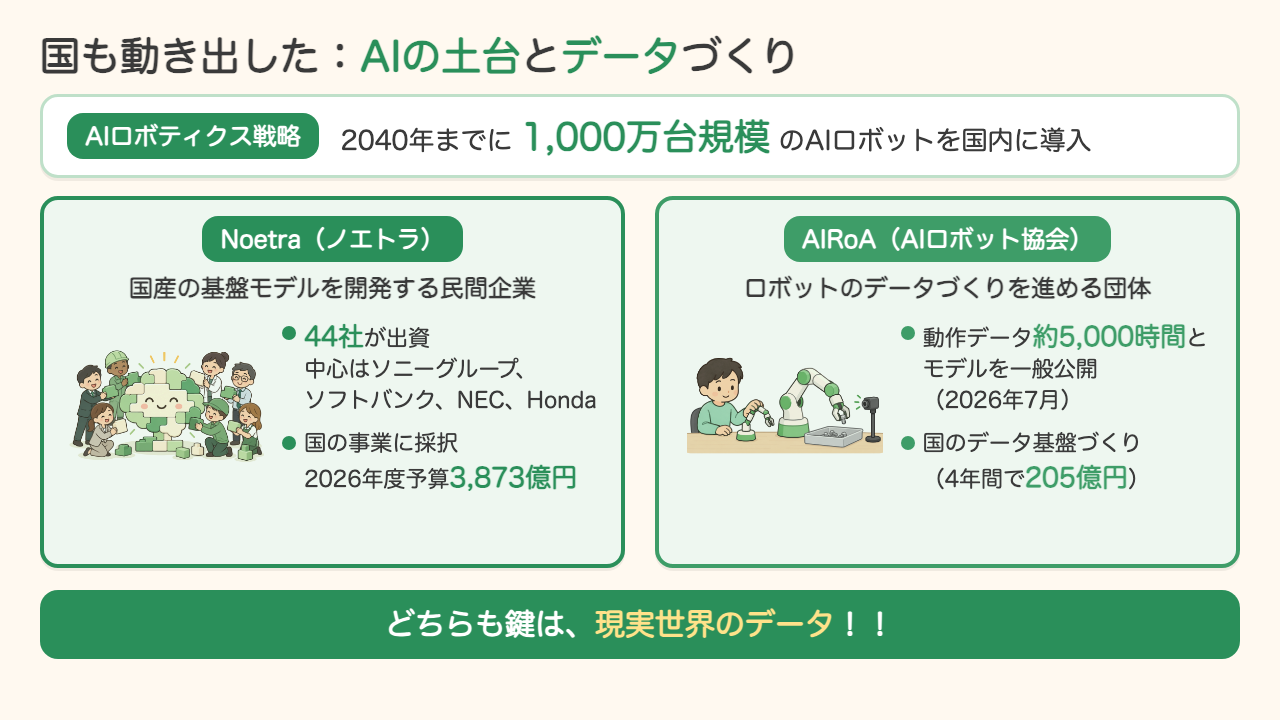
どちらの取り組みも、鍵は現実世界のデータです。政府の戦略も、「Web上のテキストデータと計算資源」による"規模"の競争から、"統合力・運用力"の競争へ重心が移りつつあると書いています。AIと機械を組み合わせ、現場データで改善し続ける力のことです。AI時代、AIの性能もさることながらデータが重要なカギになってくるんです。
なぜ"動画を見るだけ"ではダメなのか?
セミナーの概要と"模倣学習"
まずはセミナーの概要をサラッと紹介します。第1部では、APTOの遠藤俊策氏(共同創業者/AIエンジニア)が実機・現場データの話をしました。第2部では、Webデータ収集のBright DataからRyan Yan Dai氏が、Web動画を学習に使う話をしました(通訳は同社のKeiko Zeltzer氏)。
第1部で紹介された、ロボットの主な学び方は、人のお手本を真似る"模倣学習"です。人がリーダーアーム(操縦用のアーム)で実演し、カメラ映像と関節角度をセットで記録。1つの作業で数十〜数百回繰り返すそうです。
ロボットのデータは足りない、でも動画は山ほどある
ただ、この方法では作業ごとに人がお手本を見せ続ける必要があり、ロボット用のデータはなかなか増えません。代表的なデータセットで比べると、Meta社の言語AI「Llama 3」の学習テキストは15兆トークン超、画像と説明文の組を集めたLAION-5Bは58.5億組。対してロボットの実機データは、研究機関が持ち寄ったOpen X-Embodimentでも100万本超の動作記録です。単位が違うので厳密な比較ではありませんが、ロボットのデータ不足はNEDOも課題に挙げています。ネット上の文章や画像と違って、現実で動くためのデータが十分に集まっていない、というのです。
一方で、Webには人がさまざまな作業をこなす動画が山ほどあります。私たちが動画を見て技を覚えるように、ロボットもこの動画で学べたら便利だと思いませんか?第2部のBright Dataのセッションは、まさにこの"動画を教材にする"話でした。
動画に写っていない"答え"
ところが、Web動画には映像はあっても、ロボットにどんな動作指令を出せばよいかという答えが写っていません。火加減や分量の説明がない料理動画では、手順は見えても同じ味は再現できませんよね。
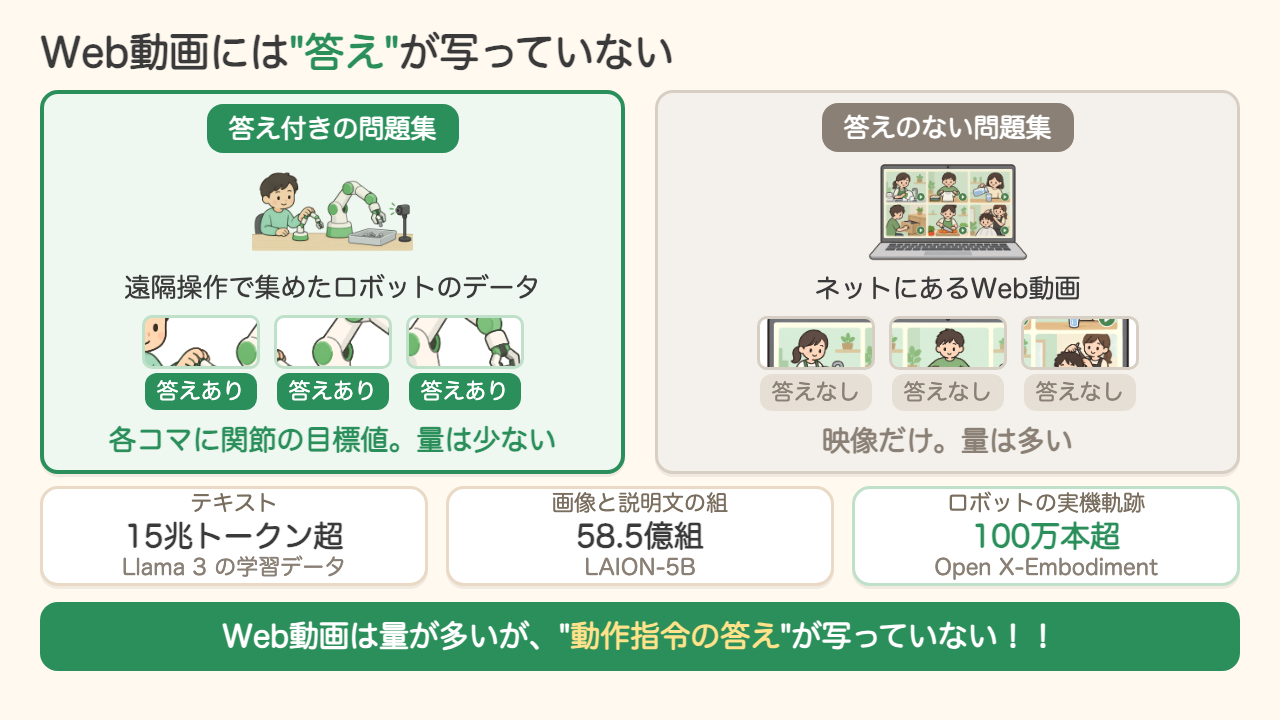
セミナーでも、人間のように動画を見て学べないのか、という趣旨の事前質問が取り上げられました。これに対するBright Dataの答えは、まず大量の動画から該当する場面を探すこと、でした。同社の持ち場は場面を見つける工程で、映像を動きに変えるのは別の技術。答えは合わせ技になるわけです。
では、答えのない動画は役に立たないのでしょうか?・・・実は、そうとも言い切れません。セミナーで示された"答えのピース"を1つずつ見ていきましょう!!
答えのピース① Web動画は"世界の動き方"を教えてくれる
下ほど量、上ほど現場 — "データピラミッド"
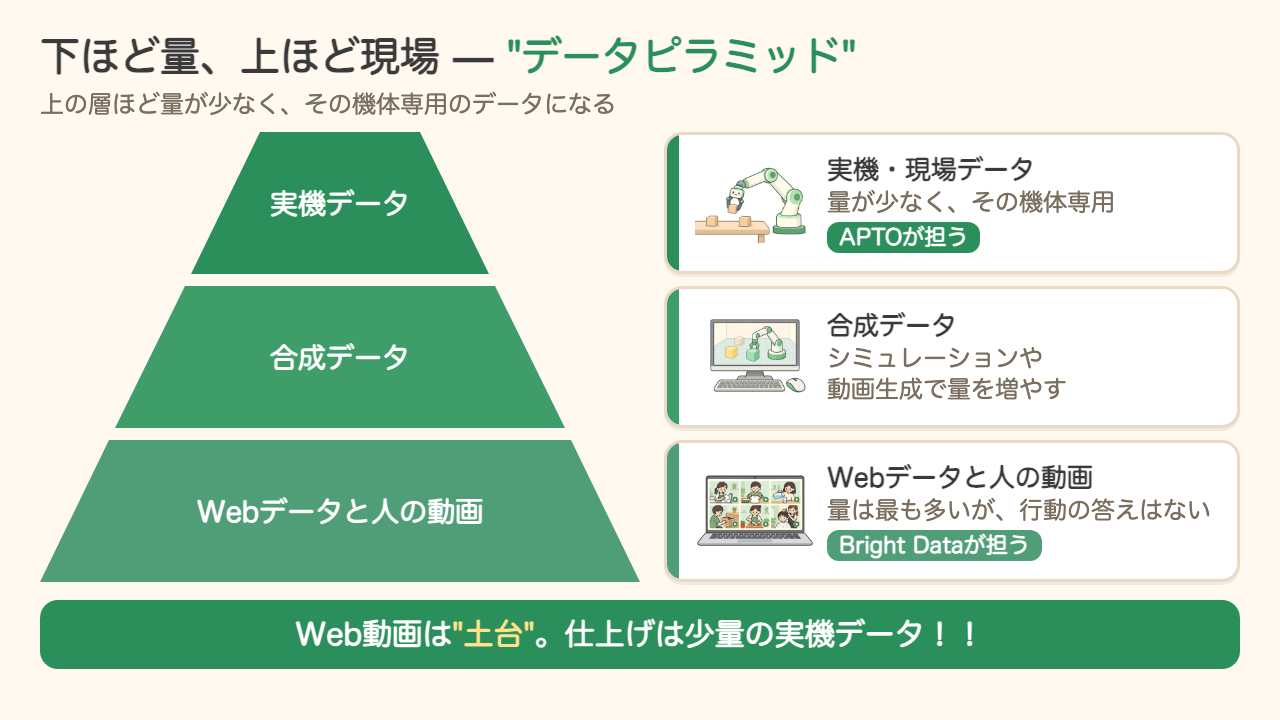
ロボットの学習データは、3つの層で考えると分かりやすくなります。下からWebデータと人の動画、合成データ、実機データの3層で、上ほど量が少なく、その機体専用になります。NVIDIAがロボット向けの基盤モデル「GR00T N1」の論文(2025年3月)で示した、"データピラミッド"という考え方です。
セミナーでは、この層の考え方に沿って、下のWebデータをBright Dataが、上の実機・現場データをAPTOが担う、と説明されていました。下の図は、論文の図を基に、セミナーでの説明に沿って社名を書き加えたものです。
また、「環境をどんどん変えていくと、急激に精度が落下していく」のが今のフィジカルAIの現状だ、という話も印象的でした。地元では迷わない人が、初めての街では駅の出口すら分からなくなる・・・あの感じですね。そこで、いろいろな場面の動画で下地を学び、実機データで仕上げる研究を見てみましょう。
100万時間の動画と、62時間未満のロボットデータ
Bright Dataのスライドは、Web動画が機械に世界がどう動くかを教える例として「MetaのあるAIモデル」を挙げています。論文をたどるとV-JEPA 2(2025年6月)です。
V-JEPA 2は、ネット動画100万時間超で事前学習(本番前に大量データで下地を作る学習)し、手先の動きの記録付きロボットデータ(62時間未満)で仕上げています。その結果、学習データにない研究室でも、途中の目標画像(途中経過の"お手本"となる写真)を与える形でピック&プレース(物を掴んで置く作業)に成功しています(成功率はMetaの発表で65〜80%)。常識は動画で、手さばきは実機で、というわけです。
Bright Data自身もスライドに「実際のロボットによる練習も少しは必要」と書いています。前回の記事で試した転移学習(別の大量データで学んだ下地を、少量のデータで目的の仕事に合わせ込む方法)と、同じ構図なんですよね。
前後2コマから「何が動いたか」を推定する
スライドには「しかし、オンライン動画ではロボットの動き方がわからない」という想定反論もあり、AIは2つのコマを見て何が動いたかを推測し、欠けた動作指令を補える、としていました。
セミナーの後で調べると、コマの変化から動きの記号を学んで事前学習し、少量のロボットデータで実際の動きに対応づける研究がありました。例えばLAPA(2024年)です。人の動画だけでも事前学習なしよりは成績が上がりましたが、最先端のモデルには届かず、仕上げには実機データを使っています。
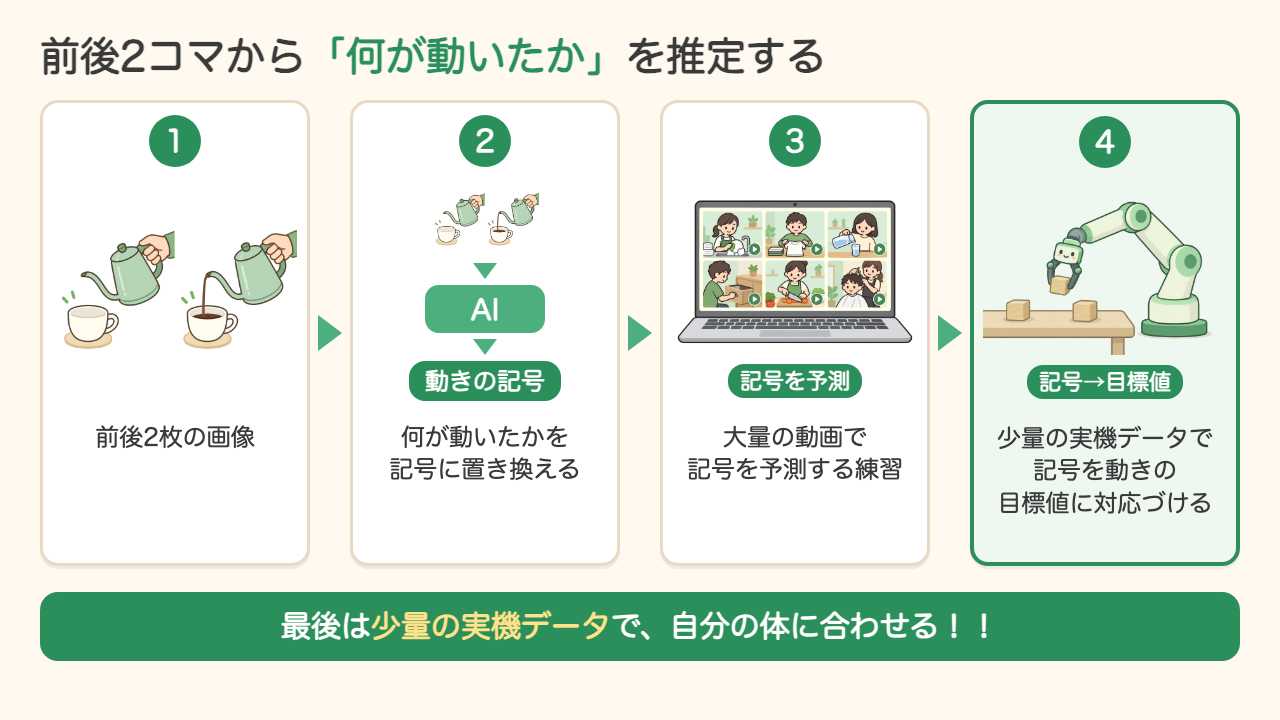
私が発見だと感じたのは、V-JEPA 2など多くの手法でロボットに渡す"行動"が、トルク(関節を回す力)ではなく関節の目標角度や手先の位置といった目標値だということ。機械屋として、行動=関節トルクだと思い込んでいました。位置は映像に写りますが、力は写りません。
ここまでのまとめをすると、動画で"世界の動き方"という土台を学び、少量の実機データで体に合わせる、というわけです。では、その大量の動画はどう集めればいいのでしょうか?
答えのピース② まず検索、そして収集 — Bright Dataの提案
動画AIの学習では、集めた動画の多くが外される
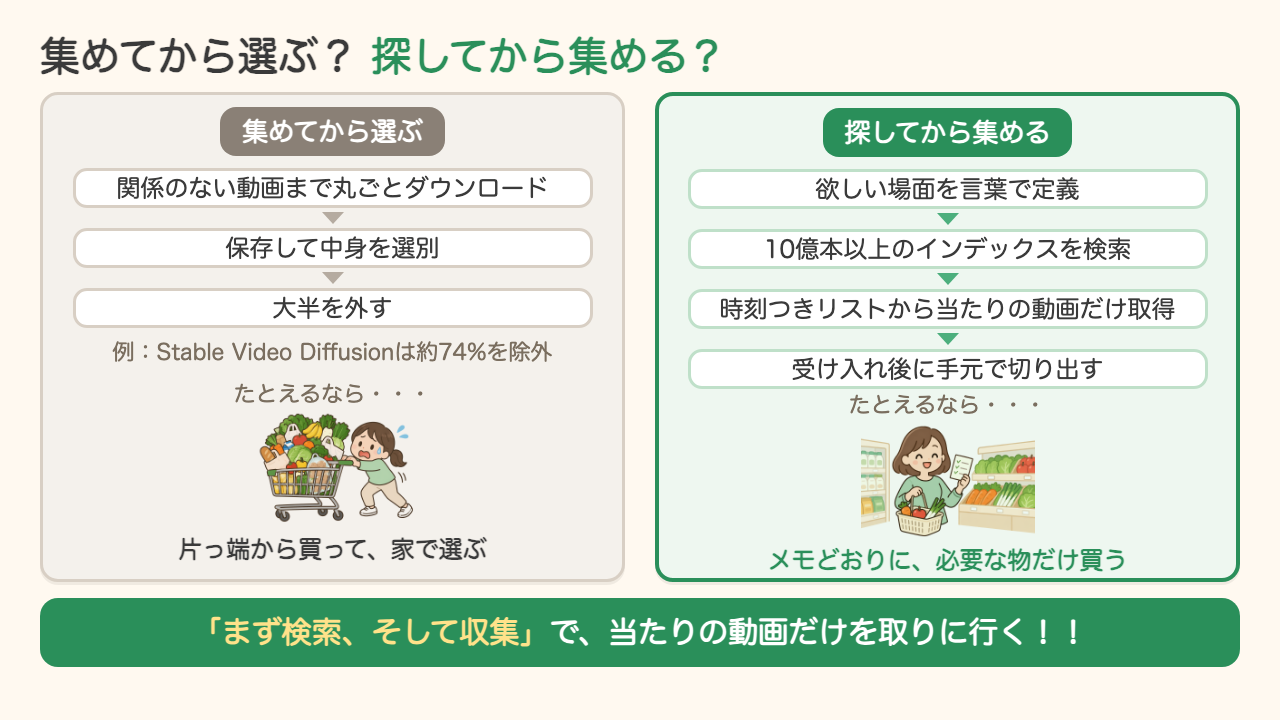
Bright Dataのスライドには「収集された動画の大部分は破棄される」とありました。論文で確かめると、Stable Video Diffusionでは約5.8億クリップを1.52億クリップに絞り込み、クリップ数で約74%を学習から外しています。
この選別自体は学習の質を上げる工程です。Bright Dataが問題にしたのは、関係のない動画まで丸ごと落としてから探す、保存・通信・計算の無駄でした。たとえるなら、献立も決めずに目についた食材を片っ端からカゴに入れて、家で選ぶようなもの。冷蔵庫に入りきりませんよね。
言葉で場面を探す"Video Search API"
そこで提案されたのが「まず検索、そして収集」です。欲しい場面を言葉で書くと、どの動画の何分何秒にあるかまで返ってきて、取りに行くのは当たりの動画だけで済みます。
製品名はVideo Search API(ベータ版)。APIは、プログラムから機能を呼び出す窓口のことです。同社によると、10億本以上のWeb動画を映っている中身で整理していて、文章や画像で検索できます(2026年10月時点)。動画そのものは別のMedia Data APIで動画単位に取得し、時刻を頼りに手元で切り出す形です。
デモには、部品の組み立てや操作パネルの操作といった製造業っぽい検索例も登場しました。会場からのリクエストで日本語の「髪の毛を切っている動画」を入れると、海外の散髪動画が並びました。
最後にRyan氏が「将来、ロボットに髪を切ってもらうことを信頼できると思いますか?」と問いかけると、会場の参加者の一人は「モデル次第。でも今はノー」(筆者訳)。私も前髪だけは、当分人間にお願いしたいところです。
プロンプト(検索の指示文)は、いわば"買い物メモ"です。メモがあいまいなら、買ってくる物もあいまいになります。質疑応答でもBright Data側から、汎用か製造ライン専用かなどを先に決め、得意にさせたい場面を定義してから学習データを選ぶべきだ、という意見が出ていました。
🔍 ロボット学習用の"場面"を探したい方へ
動画で下地を学んだら、最後は実機での仕上げです。そのデータの集め方と品質について、APTOの話を見ていきましょう。
答えのピース③ 最後は実機データと"検品" — APTOの現場から
うまくいく作業、まだ難しい作業
APTOは自らを「AIデータカンパニー」と呼び、AI学習データの収集や正解付け(アノテーション)を手がけています。
APTOの説明では、部品を箱に移すキッティングはかなり精度高く成功しており、失敗しても自分でやり直して最後に蓋まで閉めます。一方、反射の強いL字ブラケット(L字型の取付金具)は挑戦中で、Tシャツ畳みは今のところ社内ではうまくいっていない、とのことでした。
冒頭のハウツー動画の話を思い出してください。Tシャツの畳み方の動画はWebに山ほどあるのに、APTOの現場でも実機で畳むのはまだ難しいのです。
APTOの検品は、まだ人の目が頼り
では、集めたデータの良し悪しは、どう見分けているのでしょうか? APTOによると、使えるデータかどうかを確実に見分けるには、今も人の目で見るしかないそうです。質疑応答では、今も半分〜7割は人が確認し、残りはVLM(画像を見て言葉で答えるAI)が自動でラベルを付けていると説明されていました。
APTOはAWS(Amazonのクラウド)の公式ブログへの寄稿で、カメラの同期ずれ(記録時刻のずれ)を監視し、品質が落ちたら収集を止める仕組みも紹介しています。質の悪いデータを、学習に混ぜないための仕組みです。下の図は、セミナーでの説明をもとに、この分担を描いたものです。
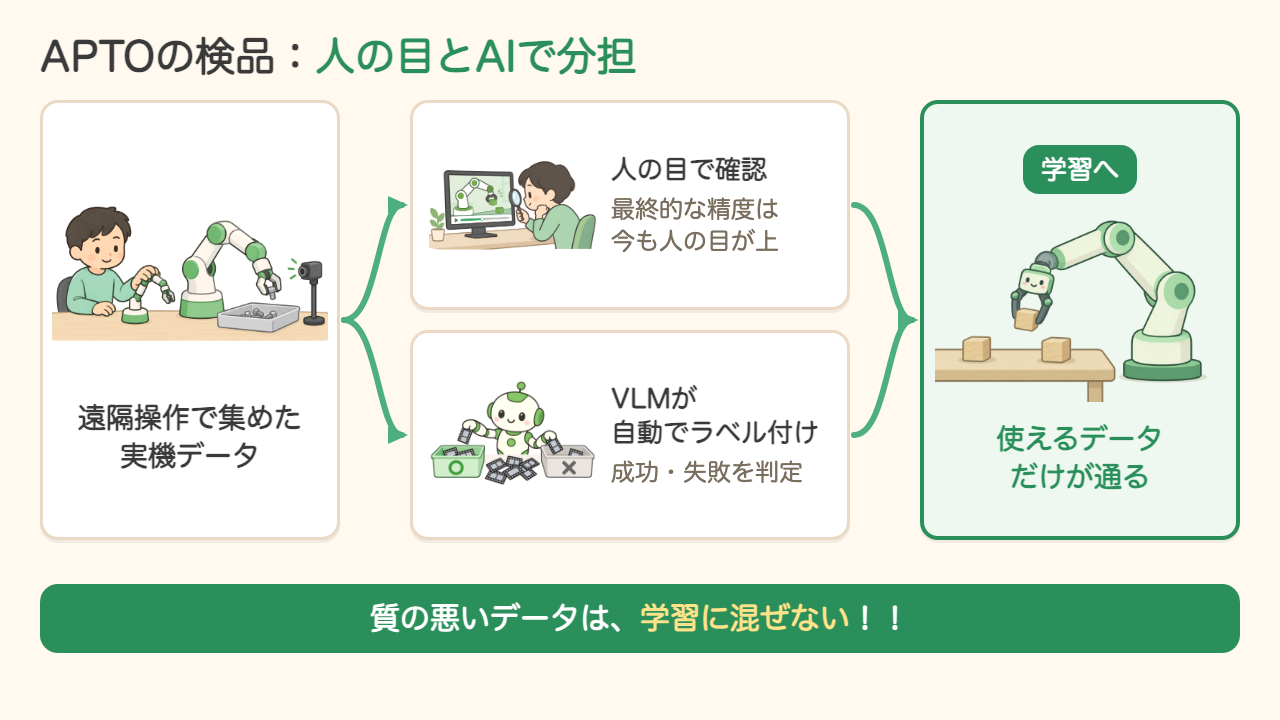
今回の話でいえば、Bright Dataは集める前に選び、APTOは集めた後に選ぶ。両社とも、実は選別の話をしていたのです。では、冒頭の問いに答えを出しましょう!!
まとめ:ロボットはWeb動画で賢くなれるのか?
ロボットはWeb動画で賢くなれます。ただし学べるのは"世界の動き方"という土台まで。"自分の体の動かし方"は、少量でも質の高い実機データで仕上げる必要があります。
もちろん限界もあります。力や触覚は映像に写りません。それを補うのが実機のデータで、何をどう記録するかが問われます。
日本でデータを作る意味を問われたAPTOの答えは、量では勝てないので、専門的な領域や0.1mmの誤差といった高精度な作業のデータに力を入れていく方針でした。現場データを重視する点は、先ほどの政府の戦略とも通じます。量より質で勝負する考えには私も賛成で、その品質は、収集の仕様やラベル、使えるデータの割合で示すものだと思います。さらに、食品の産地表示のように、どこで集めたデータなのかという来歴も要るのではないでしょうか。
学び方に加えて、動画を使う条件の確認も欠かせません。公開されている動画でも、見られることと学習に使ってよいことは別の話で、各サービスの利用規約を確かめる必要があります。日本の著作権法30条の4も、作品を楽しむためではない情報解析(AI学習など)での利用を広く認める一方、著作権者の利益を不当に害する場合は対象外です。なおBright Dataは、結果に元動画のURLとタイムスタンプが付き、権利の判断は利用者が行うと説明しています。
さて、本記事の内容を復習しましょう。
- フィジカルAIは答えを"動き"で返すAI。日本は国を挙げてモデルとデータを育てている
- Web動画には、ロボットへの動作指令という"答え"が写っていない
- Web動画はデータピラミッドの"土台"。仕上げは少量の実機データ
- Bright Dataは「まず検索、そして収集」を掲げ、Video Search APIを提案している
- APTOは実機データの収集と検品に取り組む
ロボットも"見て盗む"ことはできます。ただし盗めるのは"型"まで。"手の感覚"は、最後は実機で磨き上げる必要があるのです。
あなたの現場の当たり前の動きが、いつかロボットの教科書になる日が来るのかもしれません。気になった方は、冒頭のアーカイブ動画で、登壇者の話もぜひチェックしてみてください。
🚀 Bright Data を無料で試す — まずはWebデータ収集から